Un modello di testo al volante: GPT-6 guida una Corolla al drive-thru
Tre ingegneri di una startup chiamata Axiom hanno collegato il modello GPT-6 Astra di OpenAI alle telecamere e al servosterzo di una Toyota Corolla del 2024, facendogli percorrere la corsia del drive-thru di un In-N-Out Burger in California. L'esperimento è raccontato da Wired.
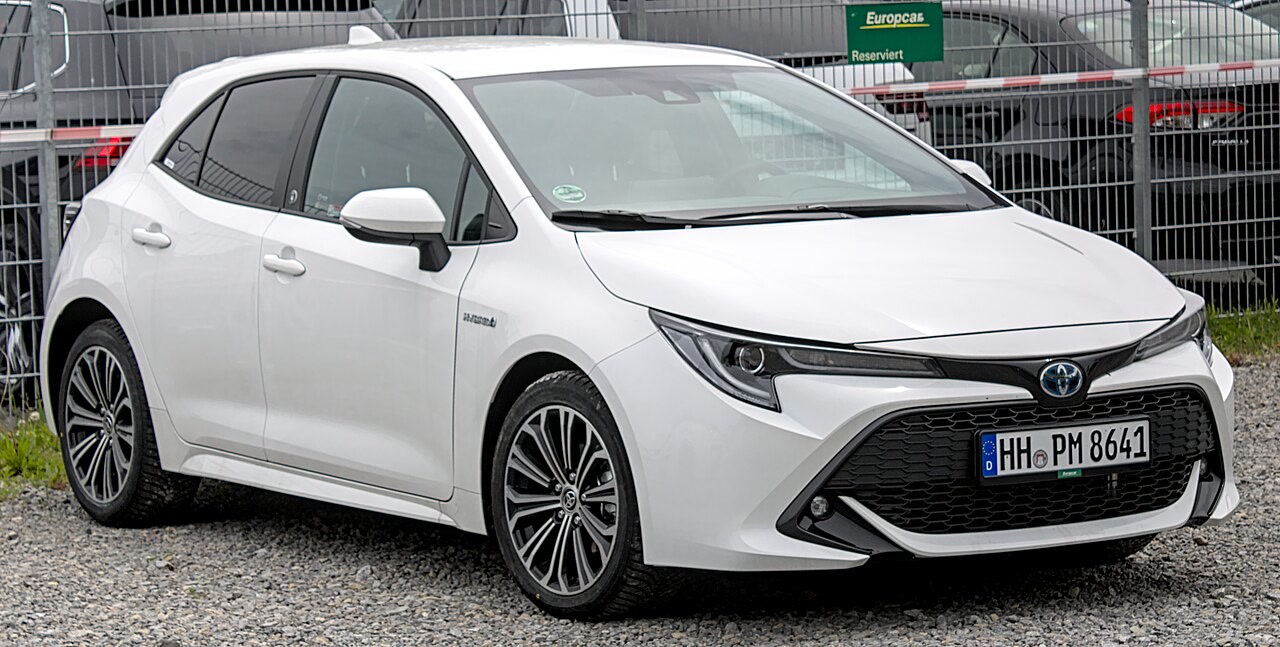
- GPT-6 Astra ha guidato una Toyota Corolla fino alla finestra di un drive-thru, con un guidatore di sicurezza a bordo.
- Il modello non era addestrato alla guida: osservava le telecamere e decideva la manovra passo dopo passo.
- L'esperimento suggerisce progressi nel ragionamento fisico dei modelli linguistici, ma con rischi evidenti.
L'esperimento
Aditya Ramabadran, Simon Mahns e Tobias Gessler hanno aperto un portatile seduti in auto vicino al ristorante e hanno chiesto al modello di prendere il controllo. Un'interfaccia di chat era collegata a un server, a sua volta connesso a varie telecamere montate sul parabrezza e al sistema di sterzo assistito del veicolo. Al posto di guida restava una persona pronta a frenare.
Il modello, che normalmente serve a produrre testo, codice e qualche immagine, ha guidato lentamente ma senza incidenti fino alla finestra per ritirare il cibo. "Forse l'AGI è già qui", ha commentato uno degli ingegneri, riferendosi all'intelligenza artificiale generale, cioè l'idea di macchine capaci di eguagliare l'intelligenza umana.
I tre avevano provato prima con Grok di SpaceXAI e poi con i modelli più recenti di OpenAI e Anthropic. All'inizio i sistemi si rifiutavano di prendere il volante, rispondendo che potevano interpretare immagini stradali ma non impartire comandi. L'esperimento è stato condotto al di fuori del loro lavoro in Axiom.
Perché un modello di testo riesce a guidare
Le auto a guida autonoma non sono una novità, ma funzionano con algoritmi addestrati appositamente per quel compito. Qui invece il modello non aveva ricevuto alcun addestramento specifico: osservava le immagini delle telecamere e decideva la manovra successiva passo dopo passo, improvvisando sul momento.
Secondo Wired, l'episodio e altri esperimenti simili indicano che i modelli linguistici stanno acquisendo una comprensione rudimentale ma utile del mondo fisico. È il cosiddetto ragionamento fisico, considerato dai laboratori una frontiera ancora da conquistare. Andrew Dai, ex ricercatore di Google DeepMind e oggi amministratore delegato della startup Elorian AI, sostiene che un ragionamento visivo migliore aprirà applicazioni nuove, dai sistemi che capiscono se un cliente sta gradendo il pasto ai robot domestici. Elorian e Scale AI hanno messo a punto un benchmark, cioè un test standardizzato, chiamato Humanity's Sixth Sense, per misurare quanto un modello comprende una scena fisica.
Perché conta
Gli stessi ingegneri ammettono che mettere un modello generalista al comando di due tonnellate d'acciaio in movimento è un'operazione ad alto rischio. Durante il test non è successo nulla di allarmante, ma il punto resta: man mano che questi sistemi capiscono meglio lo spazio e gli oggetti, usciranno dallo schermo per agire nel mondo reale, con effetti potenzialmente utili e potenzialmente pericolosi.
Per chi vive in Italia la ricaduta più vicina non è l'auto senza conducente, che qui resta regolata in modo stretto, ma la prospettiva di modelli generalisti applicati a robot, macchinari e assistenti capaci di osservare un ambiente fisico e decidere cosa fare, senza essere stati programmati per quel compito preciso.